
10 Anti Pattern kinh điển khi làm việc với Coding Agent
Khi coding agent ngày càng mạnh, vấn đề dần không còn nằm ở chuyện "prompt thế nào". Phần khó hơn là làm sao để một hệ thống agent không đi rất nhanh theo một hướng sai, không biến planning thành quan liêu, không biến phối hợp thành micromanagement và không lấy chính code tạm thời của hôm nay làm chân lý kiến trúc của ngày mai.
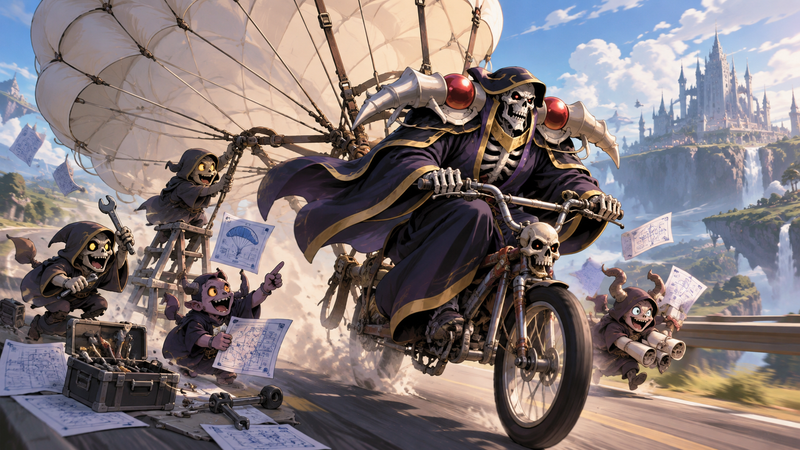
Trong bài về multi-agent orchestration và mô hình SLP, tôi có kể chuyện chiếc xe đạp gắn dù. Agent đầu tiên chọn dù để giảm tốc, những agent tới sau tiếp tục tối ưu cái dù: làm nó nhẹ hơn, bung nhanh hơn, thu lại gọn hơn. Mọi task đều có thể hoàn thành rất tốt, CI xanh, review đẹp, nhưng cả đội vẫn đang tối ưu một lựa chọn chưa chắc đáng tồn tại. Thứ tôi cần từ đầu có thể chỉ là một cái phanh.
Càng làm việc lâu với coding agent, tôi càng thấy những lần đâm vào tường thường không đến từ việc agent không biết code. Chúng đến từ cách chúng ta giao task, chia task, khóa quyết định và diễn giải trạng thái hiện tại của codebase. Human có thể chốt solution khi còn chưa hiểu outcome. Lead có thể chia một thay đổi thành quá nhiều phase rồi tự tạo ra hàng loạt trạng thái trung gian. Một bản plan quá chi tiết có thể khóa luôn implementation trước khi agent trực tiếp implement kịp đưa ra quyết định tốt hơn.
Series này là tập hợp guideline từ kinh nghiệm cá nhân và các anti-pattern đã nhiều lần đẩy tôi xuống hố: những cách làm nhìn qua rất có tổ chức, rất "engineering", thậm chí đôi khi còn khiến agent làm việc trơn tru hơn, nhưng lại âm thầm làm chất lượng quyết định tệ đi. Tôi không cố đưa ra một methodology duy nhất để mọi người làm theo. Tôi chỉ muốn chỉ ra những chỗ mà agent có thể làm đúng từng task nhưng cả hệ thống vẫn đi sai.
1. Bắt đầu lắp xe đạp
Coding agent càng mạnh, khả năng chúng ta nhảy vào những domain mà trước đây mình không dám đụng tới càng cao, một phần là vì nó giúp chúng ta khám phá và hiểu một domain mới nhanh chóng, một phần rảnh quá mua thêm việc vào người. Một backend developer có thể bắt đầu làm mobile app, một web developer có thể thử viết compiler tooling, một team nhỏ có thể đụng tới những bài toán hạ tầng mà trước đây phải cần cả một nhóm specialist. Đây là một trong những thứ tôi thích nhất ở agent: nó làm chi phí bước vào một lĩnh vực mới thấp đi rất nhiều. Nhưng chính điều đó cũng tạo ra một kiểu nguy hiểm mới. Code có thể được viết nhanh hơn rất nhiều so với tốc độ chúng ta thực sự hiểu domain mình đang bước vào.
Ngay cả khi đã có kiến thức nhất định về một domain, tôi vẫn luôn giữ thái độ hoài nghi với những phán đoán ban đầu. Trong giai đoạn khám phá, việc thử nghiệm nhiều hướng tiếp cận thường hiệu quả hơn rất nhiều so với việc cố định một giải pháp quá sớm và có nguy cơ đi sai đường trong nhiều tuần. Thách thức lớn nhất khi đối mặt với một domain hoàn toàn mới là đôi khi ngay cả mục tiêu cuối cùng cũng chưa rõ ràng. Có những vấn đề thoạt nhìn rất quen thuộc, với những công nghệ và khái niệm đã từng sử dụng, tạo cảm giác rằng chúng ta đã hiểu rõ. Nhưng càng đi sâu, càng nhận ra rằng những gì mình biết chỉ là một phần nhỏ của bức tranh tổng thể. Nền tảng tổng đài/voice platform Echo mà tôi đã phát triển là một minh chứng điển hình cho điều này.
Khoảng 12 năm trước, tôi và ku em Bố Gấu từng làm một trang phỏng vấn xin việc online qua WebRTC. Xa hơn nữa, khoảng 15 năm trước tôi cũng từng dạy lập trình web online bằng livestream (nên nếu ai nghi ngờ danh hiệu "bố của khầy" do tôi tự phong thì có thể inbox xin danh sách học viên đời đầu). Nói cách khác, realtime audio/video, buffering hay truyền media qua internet không phải là những thứ hoàn toàn xa lạ với tôi. Nhưng khi bắt đầu Echo, tôi vẫn nhận ra mình thiếu rất nhiều kiến thức ở phần viễn thông. Tôi chưa hiểu rõ SIP trunk hoạt động thế nào, nhà mạng xác thực ra sao, luồng cuộc gọi từ provider đi tới hệ thống của mình như thế nào, hay các thứ như số 1800, 1900, voice brandname và caller ID thực tế phụ thuộc vào kỹ thuật hay quy trình của nhà cung cấp tới đâu.
Ở giai đoạn đó, khi đang lái xe (xanhsm), tôi chỉ nói chuyện sơ qua với Gemini để định hình bài toán. Tôi chưa cần nó chọn stack hay vẽ architecture. Tôi chỉ cần biết trong domain này có những khái niệm nào, chúng liên quan với nhau ra sao và nếu muốn tìm hiểu sâu hơn thì nên dùng keyword gì. Khi có thời gian ngồi xuống, tôi tiếp tục trên web UI của Gemini hoặc ChatGPT, lần lượt bóc những chỗ mình chưa hiểu thay vì yêu cầu nó thiết kế luôn cả hệ thống.
Những câu hỏi hữu ích lúc đó thường khá cơ bản: nếu nhân viên dùng ứng dụng web để gọi tới số điện thoại của khách hàng thì có những cách nào? WebRTC giải quyết phần nào? SIP trunk nằm ở đâu? Phần nào do hệ thống của mình giữ, phần nào do provider chịu trách nhiệm? Khi mất kết nối thì chuyện gì xảy ra? Muốn triển khai thật thì phải hỏi nhà cung cấp những gì trước? Tôi không cần AI trả lời thay provider. Tôi cần nó giúp mình có đủ vocabulary để biết phải hỏi gì tiếp theo.
Ngay cả chuyện network cũng vậy. Chỉ biết "có SIP" hay "có tunnel" là chưa đủ. Tôi cần hiểu rằng tín hiệu điều khiển cuộc gọi và luồng audio không nhất thiết đi cùng một đường, từ đó mới biết phải hỏi endpoint nào cần kết nối được với endpoint nào, firewall phải mở cho phần nào và provider yêu cầu topology ra sao. Tương tự với caller ID, voice brandname hay giới hạn số cuộc gọi đồng thời: có thứ mình giải quyết được bằng code, có thứ phải do nhà mạng hoặc provider cho phép. Những cuộc trao đổi ban đầu chỉ cần giúp tôi phân biệt được ba loại đó.
Sau khi có một bản đồ sơ bộ của domain, tôi mới đưa bài toán lên tầng orchestration. Lúc này Supervisor không cần nhảy vào source code. Việc đầu tiên của nó là giúp tôi làm rõ outcome, các constraint đã biết, những giả định nào còn chưa được kiểm chứng và những hướng tiếp cận nào có vẻ hợp lý. Với Echo, outcome không phải là "làm một demo WebRTC chạy được", mà là xây một năng lực tổng đài có thể dùng lại cho nhiều công ty và tích hợp vào các ứng dụng nghiệp vụ như CRM, phòng khám hay bệnh viện. Từ outcome đó, chúng tôi mới có thể so sánh những hướng khác nhau, chẳng hạn dùng một dịch vụ voice có sẵn hay tự vận hành phần tổng đài rồi nối với nhà cung cấp viễn thông, và quan trọng hơn là hiểu mình sẽ phải tự chịu trách nhiệm tới đâu trong từng hướng.
Khi hướng đi ban đầu đã đủ rõ, Supervisor mới invoke Lead và truyền lại context theo cách có cấu trúc hơn: chúng ta đang xây cái gì, vì sao cần nó, constraint nào đã được kiểm chứng, assumption nào vẫn còn mở, những quyết định nào đã được đưa ra và những quyết định nào Lead vẫn được phép chất vấn. Tôi muốn Lead nhận được context như vậy thay vì chỉ một danh sách task, vì nếu chỉ truyền task thì rất dễ biến một giả định tạm thời thành yêu cầu bất biến.
Lead sau đó có thể scaffold project và bắt đầu viết code thật. Tôi khá thoải mái với bước scaffold này. Với coding agent hiện tại, folder layout, naming, module boundary hay một số abstraction ban đầu nếu chưa hoàn hảo vẫn có thể pivot tương đối rẻ. Tôi không muốn biến ngày đầu tiên của project thành một buổi thiết kế architecture kéo dài chỉ để cố đoán chính xác mọi thứ trước khi có code và evidence. Tất nhiên cũng đừng nghe tới architecture là lập tức triệu hồi nguyên bộ Clean Architecture, Hexagonal, DDD, CQRS cùng một rừng interface chỉ để CRUD vài bảng và đẩy vài event realtime. Architecture là để giảm chi phí thay đổi, bảo trì và mở rộng, không phải để biến ngày đầu tiên của project thành lễ gọi hồn enterprise Java năm 2012. Project nào phải đi qua một đống abstraction và generic mới tới được logic thật thì với tôi vẫn là rác. Hình minh hoạ dưới đây mô phỏng project Astra của Reina và AI CRM của Bờm trong hội kín.

Một ngoại lệ tôi để ý nhiều hơn là những boundary có chi phí thay đổi cao, Rust là ví dụ khá rõ. Ownership, lifetime và cách dependency đi qua các boundary có thể khiến một số quyết định nền tảng nếu sai thì việc sửa lại khó chịu hơn nhiều stack khác. Không phải vì Rust không refactor được, mà vì có những thứ nếu chốt quá tùy tiện từ đầu thì sẽ lan sâu vào codebase. Với các boundary kiểu đó tôi muốn Lead cẩn thận hơn một chút, còn lại, structure ban đầu chỉ cần đủ tốt để bắt đầu học từ hệ thống thật.
Khi đã có code và bắt đầu đụng các subsystem cụ thể, câu hỏi mới nên hẹp dần. Giả sử Echo cần một lớp realtime để đẩy trạng thái cuộc gọi, trạng thái agent, queue hay các event nghiệp vụ từ backend xuống browser. Lúc này câu hỏi không còn là "Echo nên dùng công nghệ gì?", mà là "lớp này thực sự cần đảm bảo điều gì?". Khi có cuộc gọi tới, web client cần biết đủ sớm để hiện popup và đổ chuông. Nếu mất kết nối rồi reconnect, client cần biết lại trạng thái hiện tại. Một số event có thể cần đúng thứ tự. Phần lớn traffic có thể chỉ đi từ server xuống browser, còn các action như nhận cuộc gọi hoàn toàn có thể gửi bằng HTTP bình thường.
Đến đây WebSocket chỉ là một candidate solution, không phải outcome. SSE cộng với HTTP command có thể đơn giản hơn. WebSocket có thể vẫn là lựa chọn đúng nếu hệ thống thực sự cần giao tiếp hai chiều liên tục. Một hướng khác cũng có thể tốt hơn nếu evidence cho thấy vấn đề lớn nhất không phải persistent connection mà là reconnect và dựng lại state. Đây chính là lúc chiếc xe đạp quay trở lại: tôi cần cái phanh, còn WebSocket mới chỉ là một phương án giống như cái dù.
Điều quan trọng là task gửi xuống Lead hay Peer phải giữ được distinction đó. Nếu tôi giao cho một Peer task "implement WebSocket server", nó sẽ có xu hướng tối ưu WebSocket server. Nhưng nếu task là "đảm bảo browser nhận được trạng thái cuộc gọi với latency, ordering và reconnect semantics như này, WebSocket hiện là phương án đang thử", Peer có quyền quay lại và nói rằng hướng hiện tại không hợp lý. Nó có thể phát hiện phần lớn traffic chỉ là one-way, hoặc state reconstruction quan trọng hơn việc giữ connection sống liên tục. Một prototype với provider cũng có thể cho thấy topology ban đầu của chúng ta sai hoàn toàn. Những evidence như vậy phải có đường quay ngược trở lại Lead, Supervisor và cuối cùng là outcome ban đầu.
Việc này cũng ảnh hưởng trực tiếp tới cách Lead phân rã công việc. Những phần có boundary ổn định và tương đối độc lập, như một CRUD API hay một provider adapter, có thể chia ra làm song song khá sớm. Nhưng với những phần mà quyết định ở bước sau phụ thuộc vào những gì học được ở bước trước, thì không nên ngồi từ đầu tưởng tượng ra toàn bộ dependency graph rồi bắt mọi người tuân thủ tuyệt đối. Càng làm, chúng ta càng biết thêm. Decomposition vì vậy cũng phải có quyền thay đổi theo evidence.
Đó là lý do tôi muốn mỗi task luôn có thể truy ngược về outcome của human, đủ context để người thực hiện hiểu vì sao nó tồn tại, đồng thời phân biệt rõ ba thứ: yêu cầu thực sự, constraint đã được kiểm chứng và solution hiện đang được chọn. Solution có thể thay đổi. Structure có thể thay đổi. Cách phân rã task cũng có thể thay đổi. Thứ không nên bị mất trong quá trình giao task xuống peer là "mong muốn thật sự của human". Nếu bỏ mất phần đó, ta hoàn toàn có thể có một Supervisor cực kỳ sôi nổi, một Lead phân rã công việc rất tốt, hàng loạt Peer làm đúng task, CI, test xanh toàn bộ và cuối cùng nhận được một bộ dù được thiết kế hoàn hảo.
Trong khi thứ tôi cần từ đầu vẫn chỉ là một cái phanh.
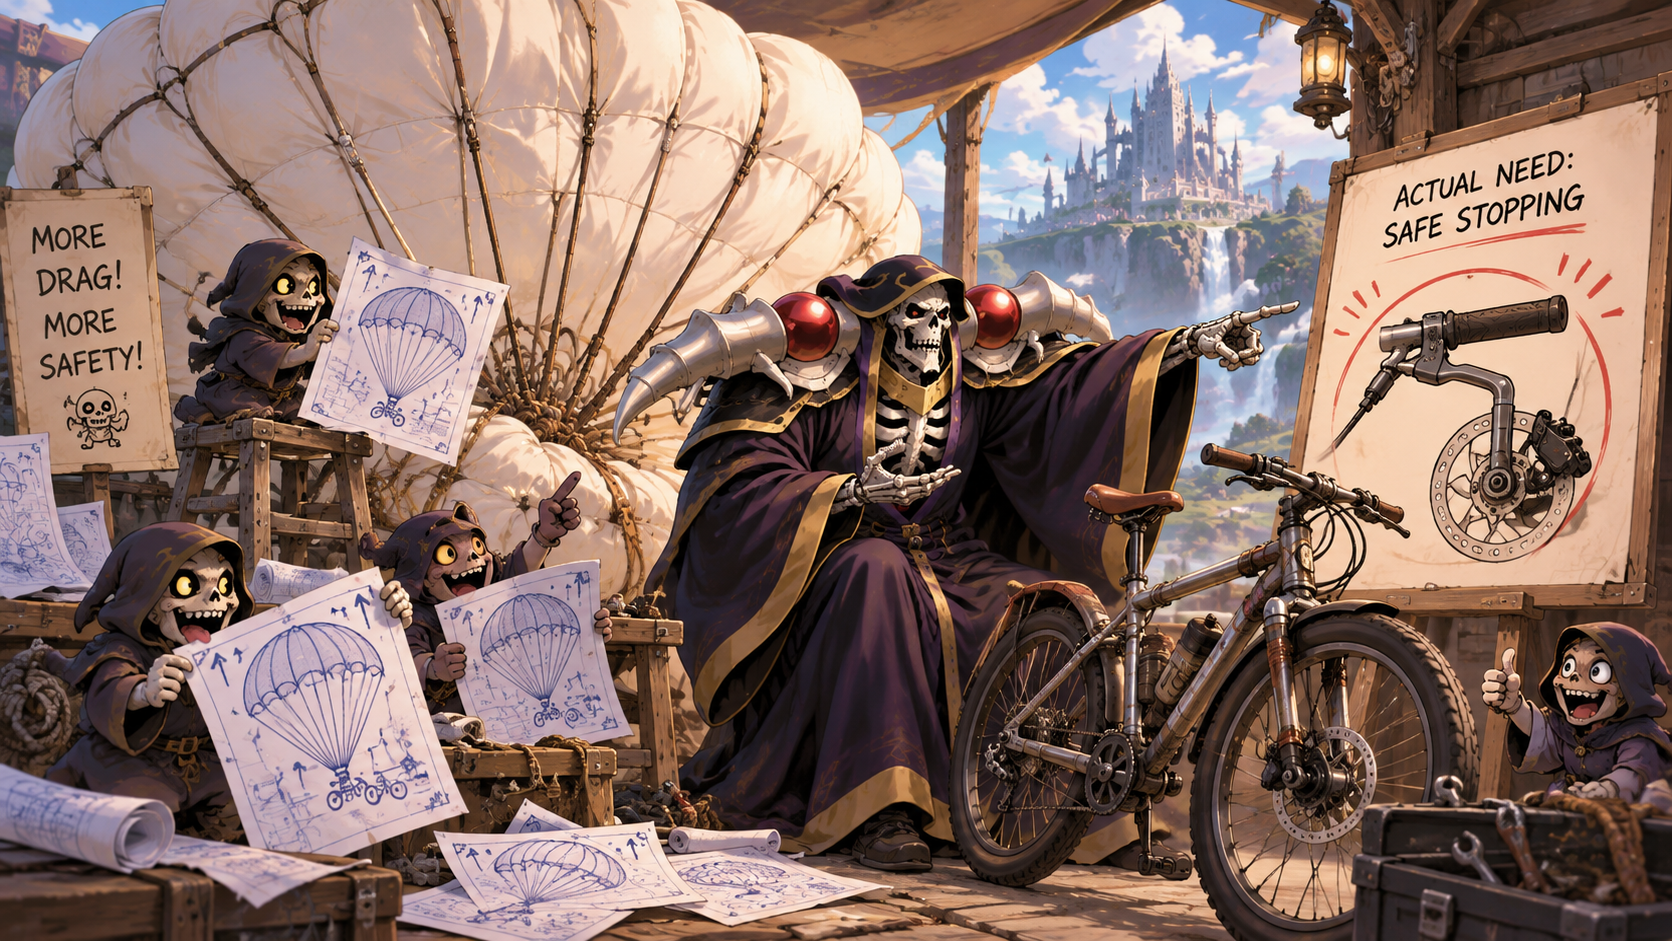
2. Đổi từ dù qua phanh bằng một plan có quá nhiều phase trung gian
Một anti-pattern tôi gặp khá thường xuyên là agent biến một thay đổi tương đối gọn thành một kế hoạch có quá nhiều phase trung gian. Nhìn rất chuyên nghiệp, rất giống tài liệu đem vào một cuộc họp lớn, nhưng đọc xong đôi khi vẫn không biết hôm nay thực sự cần sửa cái gì.
Tôi không phản đối phase. Phase có ích khi nó phản ánh một dependency thật, một mốc cần kiểm chứng hoặc một giới hạn triển khai mà hệ thống thực sự có. Nếu phải migrate dữ liệu của user đang chạy production, phải rollout dần giữa nhiều service hoặc cần giữ compatibility với client cũ trong một khoảng thời gian thì việc chia phase hoàn toàn hợp lý. Vấn đề bắt đầu khi chúng ta chia phase chỉ vì một kế hoạch trông có vẻ "đúng quy trình" hơn khi có nhiều phase.
Giả sử hệ thống đang dùng một abstraction cũ là OldStore, và mục tiêu cuối cùng là thay nó bằng NewStore. Nếu làm theo trạng thái cuối cùng, việc cần làm thực ra khá rõ: tạo NewStore, chuyển các consumer sang dùng nó, cập nhật test rồi xóa OldStore.
Nhưng nếu plan chia việc thành nhiều phase cứng, ví dụ phase 1 chỉ được thêm NewStore, còn phase 2 mới được sửa consumer, thì ngay sau phase 1 hệ thống rơi vào một trạng thái trung gian: abstraction mới đã tồn tại nhưng toàn bộ code thật vẫn đang dùng abstraction cũ. Nếu NewStore có interface hoặc semantics khác OldStore, ta thường phải làm thêm một lớp adapter để hai bên nói chuyện được với nhau. Nếu một số consumer được migrate trước, số còn lại vẫn dùng đường cũ, hệ thống lại phải giữ đồng thời hai cách truy cập dữ liệu. Nếu hai đường đó không hoàn toàn giống nhau về cache, transaction, error handling hay lifecycle, ta còn phải viết thêm compatibility code để đảm bảo trong thời gian chuyển đổi cả hai vẫn cho behavior chấp nhận được.
Khi ấy codebase không còn có hai trạng thái đơn giản là "trước migration" và "sau migration". Nó có thêm một trạng thái thứ ba do chính plan tạo ra: nửa cũ, nửa mới. Trạng thái này cũng phải compile, phải chạy test, phải được review và đôi khi còn phải được deploy. Mỗi abstraction tạm, adapter tạm hay nhánh compatibility đều trở thành code thật mà agent phải hiểu và bảo trì, dù ngay từ đầu chúng ta đã biết vài phase sau sẽ xóa nó đi.
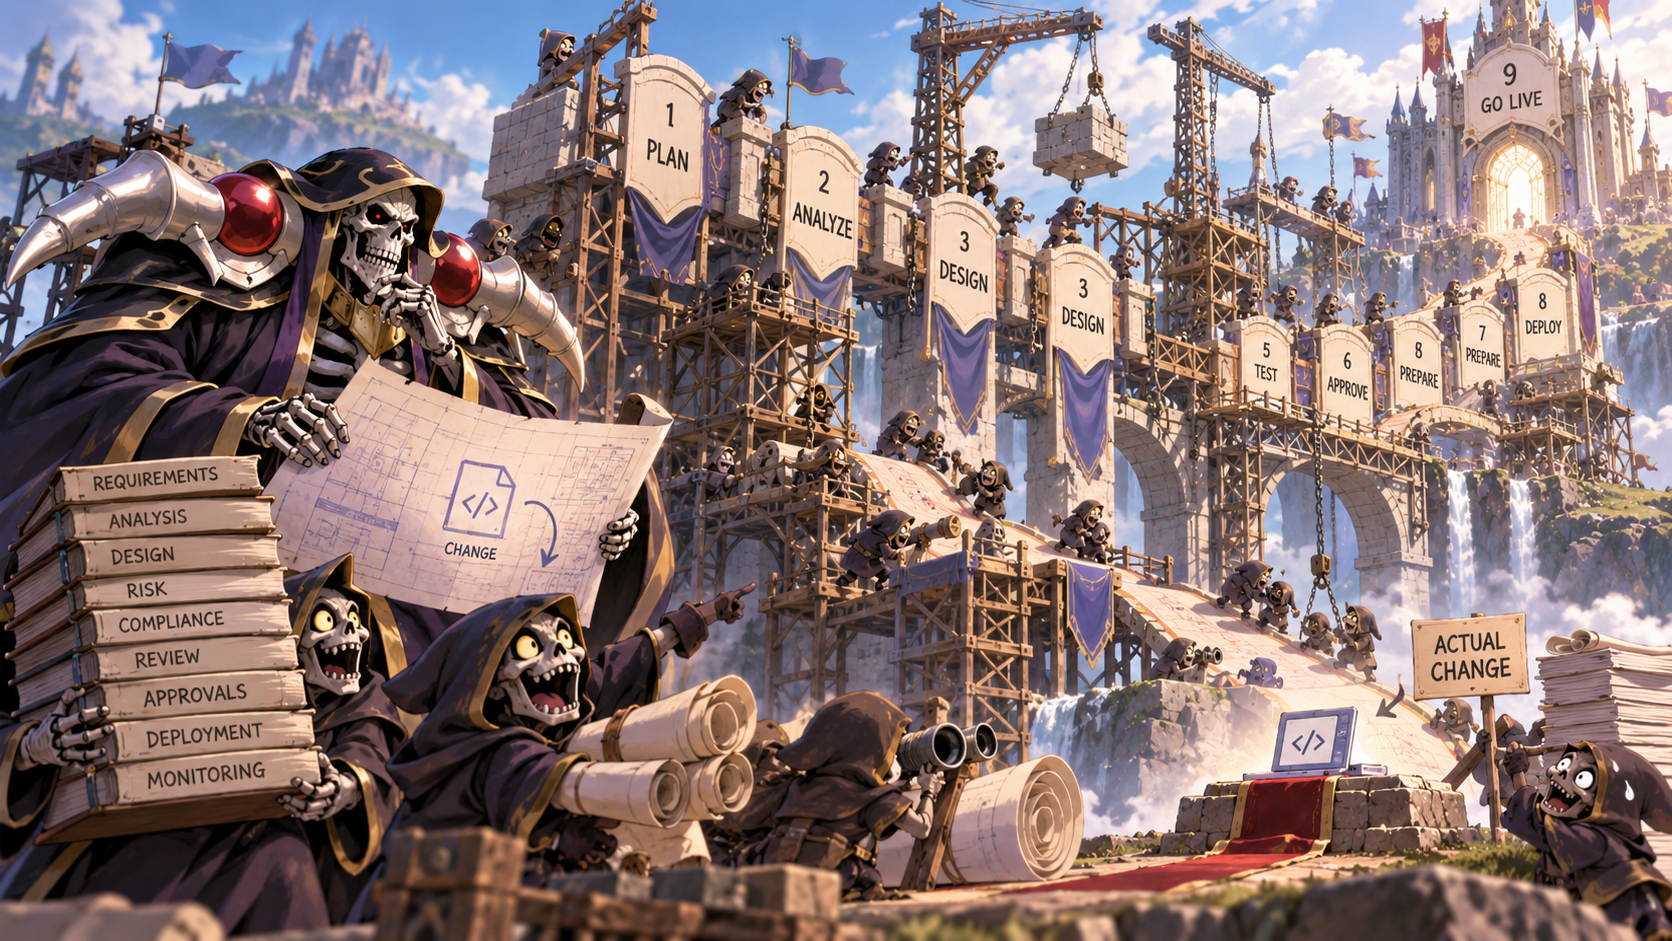
Điểm tôi muốn nói không phải là mọi migration đều nên làm một phát. Có những hệ thống đang chạy production, có nhiều service hoặc nhiều client độc lập thì trạng thái chuyển tiếp là bắt buộc. Nhưng nếu toàn bộ thay đổi nằm trong cùng một codebase, có thể sửa các consumer và kiểm chứng chúng trong cùng một vòng implementation, thì việc cố tình giữ cả đường cũ lẫn đường mới chỉ vì plan đã chia thành ba hay bốn phase có thể là một chi phí hoàn toàn giả tạo.
Nói cách khác, đôi khi ta không chia phase để phục vụ dependency của hệ thống. Ta tạo dependency mới chỉ để phục vụ cấu trúc của plan. Không phải những lớp trung gian đó sai về mặt kỹ thuật. Câu hỏi quan trọng hơn là: chúng tồn tại vì hệ thống thực sự cần một giai đoạn chuyển tiếp, hay chỉ vì bản kế hoạch đã tự đặt ra một giai đoạn chuyển tiếp rồi buộc implementation phải phục vụ nó?
Đây là một khác biệt khá lớn khi làm việc với coding agent. Trước đây, refactor một nhóm thay đổi lớn thường đắt vì con người phải giữ rất nhiều context trong đầu, chỉnh nhiều file, kiểm tra từng call site và rất dễ bỏ sót. Chia nhỏ công việc thành nhiều bước giúp giảm rủi ro. Nhưng coding agent có thể sửa một nhóm file liên quan, cập nhật các consumer và chạy test trong cùng một vòng làm việc với chi phí thấp hơn rất nhiều. Những thay đổi liên kết chặt vì vậy không nhất thiết phải bị bẻ thành nhiều phase chỉ để tạo cảm giác an toàn.
Tôi thường muốn Lead tìm con đường implement ngắn nhất nhưng vẫn giữ correctness và sự nhất quán của hệ thống. Nếu ba thay đổi chỉ đúng khi xuất hiện cùng nhau thì đôi khi điều an toàn nhất chính là làm cả ba cùng lúc, rồi dùng compiler, test và review để kiểm chứng. Việc cố tình để hệ thống ở trạng thái nửa cũ nửa mới qua nhiều bước không làm project đẹp hơn, đôi khi chỉ tạo thêm những trạng thái tạm thời mà ta phải hiểu, test rồi sau đó xóa bỏ.
Nguy hiểm hơn là trạng thái tạm thời rất dễ sống lâu hơn dự kiến. Agent ở phase đầu biết một adapter hay compatibility layer chỉ tồn tại để phục vụ migration, nhưng agent tới sau có thể không còn context đó. Nó mở codebase ra và thấy hai đường xử lý đều đang tồn tại, test đều xanh, abstraction đều có vẻ có chủ đích, thế là mặc nhiên coi cả hai là architecture hợp lệ của hệ thống. Khi sửa bug, nó thêm test để bảo vệ behavior của đường cũ. Khi thêm feature, nó support cả hai path cho "an toàn". Một Peer khác nhìn thấy duplication lại tạo thêm một abstraction chung để gom chúng lại. Sau vài vòng, thứ vốn chỉ định tồn tại hai ngày đã có test, documentation, dependency và consumer riêng.
Tới lúc muốn xóa nó, chi phí không còn là xóa một adapter nữa. Ta phải phân biệt xem những test nào đang bảo vệ requirement thật và test nào chỉ đang đóng băng một trạng thái migration, consumer nào thực sự cần compatibility và consumer nào chỉ được viết như vậy vì nó đã tồn tại sẵn, thậm chí phải giải thích lại cho agent rằng một phần architecture mà nó đang cố bảo vệ vốn chưa bao giờ là đích đến. Temporary code khi đã có đủ test và dependency xung quanh rất dễ tự tạo ra bằng chứng giả rằng nó quan trọng.
Đây là một vấn đề đặc biệt khó chịu trong agent-driven development vì mỗi agent thường nhìn code hiện tại như một phần của specification. Con người còn có thể nhớ rằng "đống này chỉ để migrate, tuần sau xóa", nhưng context đó không tự động tồn tại cùng source code. Nếu intent không được ghi lại thật rõ, code đang chạy và test đang xanh sẽ trở thành nguồn sự thật mạnh nhất. Một trạng thái trung gian vì thế có thể từ workaround biến thành convention, từ convention biến thành contract, rồi cuối cùng thành nợ mà chẳng ai nhớ vì sao nó tồn tại.
Tất nhiên "đường ngắn nhất" không có nghĩa là lao thẳng vào code mà không suy nghĩ. Một bước discovery có thể rất đáng giá nếu chúng ta chưa hiểu dependency. Một prototype có thể cần thiết nếu có giả định quan trọng chưa được kiểm chứng. Một migration dài có thể bắt buộc nếu production không cho phép chuyển đổi hoàn toàn một lần. Nhưng mỗi bước trong plan nên trả lời được một câu rất đơn giản: nếu bỏ bước này đi và làm thẳng tới trạng thái cuối cùng thì có điều tiêu cực gì xảy ra không? Nếu câu trả lời chỉ là "plan sẽ không còn đẹp như trước" thì có lẽ bước đó không cần tồn tại.
Tip của tôi dành cho bạn, nếu agent nói một task phải làm 6 tháng, bạn hãy cho nó 6 tiếng. Nếu agent nói cái này mất 6 ngày, bạn chỉ cần đáp: "Mày có 30 phút".
Planning trong agent-driven development đối với tôi không phải nghệ thuật chia một công việc thành càng nhiều phần càng tốt. Plan là cách làm rõ dependency, risk và thứ tự implement. Nó phải giúp agent đi tới outcome với ít trạng thái tạm thời và ít code trung gian nhất có thể. Chúng ta đang trả token để implement, để viết code, không phải viết doc dài dằng dặc như Truyện Kiều. Khách hàng Mèo Cọc trong hội kín mà tôi tham gia, project của nó có 20k lines of code nhưng có 3GB document. Một lúc nữa nó sẽ comment dưới bài này để phản đối.
3. Plan chi tiết tới mức như kiểu implement bằng markdown
Planning còn có một cám dỗ khác: càng mô tả chi tiết agent phải làm gì, ta càng có cảm giác rằng mình đang kiểm soát công việc tốt hơn. Ban đầu chỉ là xác định API và behavior, sau đó plan bắt đầu ghi luôn file nào phải sửa, helper nào phải tạo, hàm nào gọi hàm nào, biến nằm ở đâu và từng nhánh xử lý phải viết theo cách gì. Tới lúc đó agent không còn thực sự implement nữa, nó chỉ đang dịch một bản pseudo-code rất dài sang source code.

Tôi nghĩ có một ranh giới cần phân biệt rõ giữa contract và implementation. Contract là những thứ nhiều thành phần hoặc nhiều người cần cùng hiểu giống nhau để có thể phối hợp: API hứa điều gì, input nào hợp lệ, trạng thái nào phải được giữ, một operation thành công có nghĩa là gì, component nào chịu trách nhiệm cho dữ liệu nào, lỗi được biểu diễn ra sao và test nào chứng minh behavior đó đúng. Những thứ này đáng được khóa tương đối chặt bởi nếu mỗi Peer tự hiểu theo một cách thì tới lúc integration chúng ta mới phát hiện cả đội đã xây những mảnh ghép không khớp nhau.
Nhưng từ contract đó xuống tới implementation vẫn còn một khoảng rất lớn mà người trực tiếp đọc code thường có nhiều context hơn người viết plan. Một helper nên tên gì, logic nhỏ nên nằm trong hàm hiện tại hay tách ra, một biến trung gian có cần tồn tại không, loop nên được tổ chức thế nào hay một đoạn code có thể tận dụng abstraction sẵn có hay không thường là những quyết định tốt nhất nên được đưa ra trong lúc implement. Tôi không cần Lead đoán trước những thứ đó từ một tầng context thấp hơn rồi biến phỏng đoán thành mệnh lệnh.
Điểm này đặc biệt quan trọng với agent vì agent rất ngoan khi nhận một specification chi tiết. Nếu plan bảo "tạo helper X trong file Y rồi gọi nó từ Z", agent có xu hướng làm đúng như vậy ngay cả khi lúc mở source ra nó thấy một abstraction hiện có phù hợp hơn. Một brief quá chi tiết vô tình biến những quyết định chưa từng được kiểm chứng thành constraint. Chúng ta nghĩ rằng mình đang làm mọi thứ rõ ràng hơn. Nhưng thực tế, chúng ta lại ngăn cản việc tìm ra những cách tốt hơn. Điều này xảy ra trước khi agent (người thực hiện công việc) có đủ thông tin để xem xét toàn bộ source code.
Tôi muốn Lead khóa những gì cần thiết để các phần việc ghép được với nhau, còn Peer có quyền quyết định những chi tiết nằm hoàn toàn bên trong scope của mình. Nếu trong lúc implement Peer phát hiện một lựa chọn nhỏ sẽ thay đổi behavior mà component khác đang phụ thuộc, thay đổi API chung hoặc phá một invariant đã thống nhất thì nó phải escalate lại. Nhưng nếu quyết định đó chỉ ảnh hưởng tới cách code bên trong được tổ chức thì cứ đóng quyết định tại chỗ. Không cần triệu tập cả bộ chỉ huy để ra quyết định hoặc làm phiền tôi.
Ranh giới này cũng giúp review có ý nghĩa hơn. Reviewer không nên hỏi "implementation có giống từng dòng trong plan không?", mà nên hỏi "implementation có giữ đúng contract, invariant và outcome mà plan muốn bảo vệ không?". Nếu Peer tìm được cách đơn giản hơn mà vẫn đáp ứng đầy đủ những điều đó thì đấy là một cải tiến, không phải chệch hướng cần bị sửa lại chỉ vì nó khác kế hoạch.
Nếu khóa quá ít, mỗi Peer có thể hiểu kế hoạch một cách khác nhau, sẽ khiến việc ghép nối các phần lại phức tạp hoặc không khả thi. Khóa quá nhiều thì plan trở thành một bản implementation viết bằng văn xuôi, chưa từng được compiler chạy qua, chưa từng nhìn thấy source code thật nhưng lại có quyền ép source code phải nhất nhất theo plan.
Cả hai cực đoan đều làm coordination tệ đi. Thứ tôi muốn khóa là ý nghĩa chung của hệ thống, không phải từng tiểu tiết của Peer đang implement nó.
Bài đầu tiên bắt đầu với ba lỗi tôi gặp thường xuyên nhất: chốt solution trước khi hiểu outcome, lập kế hoạch như đang quản lý một dự án sáu tháng, và khóa cả implementation rồi gọi đó là contract.
7 mục còn lại hiện nằm trong khóa học premium giá tổng $199 nếu mua từng cái, giảm còn $169 nếu mua cả bộ, tặng kèm một file PDF 14 trang giải thích vì sao bạn chưa đủ senior để hiểu chúng. =)) đùa chứ dài quá để hôm khác
Comments